Introdução: mais do que apenas um edifício com servidores
Um único rack de treinamento de IA carregado com GPUs NVIDIA pode consumir de 130 a 140 quilowatts. Esse é aproximadamente o consumo de energia de toda uma fileira de data center tradicional, compactada em um único gabinete. As implicações para o design das instalações são profundas: os sistemas de refrigeração projetados para racks de 5 kW não conseguem lidar com racks de 140 kW. A distribuição de energia dimensionada para cargas de trabalho empresariais não pode alimentar clusters de GPU. E o antigo manual de construção de um data center, que funcionou perfeitamente bem durante vinte anos, está sendo reescrito em tempo real.
A criação de um data center em 2026 não é o que era há cinco anos. É um empreendimento multidisciplinar que abrange imobiliário, engenharia elétrica, sistemas mecânicos, telecomunicações, segurança da informação, conformidade regulatória e, cada vez mais, sustentabilidade ambiental. Esteja você construindo uma pequena instalação de edge para dar suporte aos requisitos de latência 5G, um centro de colocation para empresas regionais ou um campus de hiperescala para cargas de trabalho de IA, os fundamentos são os mesmos, mesmo que a escala mude drasticamente.
Este guia aborda todos os principais pontos de decisão do ciclo de vida do data center, desde a primeira visita ao local até o teste final de comissionamento. Abordaremos padrões e certificações, arquitetura de energia e refrigeração, design de rede, segurança física, realidades de custos e as pressões de sustentabilidade que estão remodelando a indústria. Sem brilho de marketing. Sem listas de verificação simplificadas. Apenas as decisões de engenharia e de negócios que determinam se sua instalação será bem-sucedida ou fracassará.
O que é realmente um data center?
Um data center não é um prédio cheio de servidores. É como chamar um aeroporto de prédio cheio de aviões. O edifício é a parte menos interessante. O que importa é a infraestrutura: os sistemas de energia que mantêm a eletricidade fluindo sem interrupção, os sistemas de refrigeração que removem o calor gerado por milhares de processadores, a infraestrutura de rede que conecta esses processadores ao mundo exterior e os sistemas de segurança que protegem tudo dentro.
Basicamente, um data center é um ambiente cuidadosamente projetado para fornecer quatro coisas: energia confiável, resfriamento eficaz, conectividade de-alta largura de banda e segurança física. Todo o resto, os servidores, as matrizes de armazenamento, os switches de rede, as GPUs, é carga. A instalação existe para criar as condições sob as quais essa carga possa operar sem falhas, vinte-quatro horas por dia, sete dias por semana, durante anos seguidos.
Os data centers variam de uma única sala em um prédio de escritórios que consome 50 quilowatts até campi em grande escala que consomem mais de 300 megawatts. Uma pequena instalação de borda pode servir estações base 5G locais. Um centro de colocation pode hospedar equipamentos para dezenas de empresas. Um campus em hiperescala pode treinar modelos de IA para milhões de usuários simultaneamente. A escala muda, mas os princípios de engenharia permanecem notavelmente consistentes.
Padrões e níveis: a linguagem da confiabilidade
Antes de construir qualquer coisa, você precisa decidir quão confiável ela precisa ser. Esta não é uma questão filosófica. Ele determina cada decisão de projeto subsequente, desde quantas unidades UPS você compra até quantas torres de resfriamento você instala. E a resposta tem um custo direto e mensurável.
O sistema de níveis do Uptime Institute
O Uptime Institute desenvolveu um sistema de classificação de quatro{0}}níveis há mais de trinta anos que se tornou a linguagem comum do setor para confiabilidade. O sistema avalia a resiliência da energia, do resfriamento e da infraestrutura física de uma instalação, e não do equipamento de TI interno. Cada nível baseia-se nos requisitos de todos os níveis inferiores.

Nível I (capacidade básica)oferece 99,671% de disponibilidade com 28,8 horas de inatividade anual. Há um único caminho de energia, sem redundância, e qualquer manutenção requer um desligamento-em todo o site. Isso é adequado para ambientes de TI de escritório ou de desenvolvimento onde o tempo de inatividade é uma inconveniência, não uma catástrofe.
Nível II (redundância parcial)adiciona N+1 backup de energia e resfriamento, melhorando a disponibilidade para 99,741% com 22 horas de inatividade anual. A manutenção em componentes redundantes é possível sem desligamento, mas os sistemas primários ainda precisam de interrupções programadas.
Nível III (manutenível simultaneamente)é o padrão da indústria para instalações comerciais. Ele fornece 99,982% de disponibilidade com apenas 1,6 horas de inatividade anual por meio de redundância N+1 completa e vários caminhos independentes de alimentação e resfriamento. Qualquer componente único pode ser colocado off-line para manutenção sem interromper o data hall. Em 2024, 57,4% de toda a construção de data centers nos EUA foi construída de acordo com os padrões Tier III, com custos típicos de US$ 8 a US$ 15 milhões por megawatt.
Nível IV (tolerante a falhas)vai além com redundância 2N ou 2N+1, o que significa que cada sistema crítico tem um backup totalmente ativo e fisicamente isolado. A disponibilidade chega a 99,995% com apenas 26,3 minutos de inatividade anual. O prêmio de custo é 20 a 40% maior que o Nível III. Para uma instalação de 10 MW, isso acrescenta US$ 16 a US$ 60 milhões em custos de construção. Cada minuto de redução anual do tempo de inatividade custa aproximadamente US$ 228.000 a US$ 857.000 por 10 MW de capacidade. As instalações de nível IV são raras e normalmente reservadas para instituições financeiras, operações governamentais e infraestrutura-de missão crítica.
TIA-942: O padrão mais amplo
Enquanto o Uptime Institute Tiers se concentra na infraestrutura elétrica e mecânica, o ANSI/TIA-942 (última revisão 2024) cobre um escopo mais amplo: telecomunicações, arquitetura, elétrica, mecânica, seleção de locais, segurança contra incêndio e segurança física. Ele classifica quatro subsistemas de forma independente em uma escala de Classificação 1 a Classificação 4, e a classificação geral da instalação é determinada pela classificação mais baixa entre seus subsistemas. Um data center não pode reivindicar o status de Classificação 3 se seu sistema elétrico tiver apenas Classificação 2.
Esta é uma distinção importante: reivindicar um data center TIA-942 com classificação 3 não é o mesmo que reivindicar uma instalação Tier III do Uptime Institute. Os escopos são diferentes, as qualificações do auditor são diferentes e os processos de certificação são diferentes. Equipes de compras experientes especificam qual padrão exigem e verificam o estágio de certificação, porque uma instalação que detém apenas a certificação de Projeto não provou que a construção correspondia ao projeto.
Seleção do local: onde você constrói é mais importante do que o que você constrói
Você pode projetar o data center mais eficiente do mundo, mas se construí-lo no lugar errado, você se arrependerá por toda a vida útil da instalação. A seleção do local é a decisão mais importante em todo o processo e é também a mais frequentemente motivada por fatores não relacionados com a engenharia: incentivos fiscais, custos de terreno e proximidade da sede.
Aqui está a realidade incômoda: um campus em hiperescala pode consumir mais de 300 megawatts. Garantir tanta energia da rede não é uma questão de preencher um cheque. Em mercados-de alta demanda, como Virgínia do Norte e Cingapura, as filas de interconexão podem se estender de 36 a 48 meses. Um projeto de 70 MW em Nevada foi interrompido durante 18 meses porque a linha de transmissão mais próxima não tinha capacidade disponível. Inicie as conversas sobre serviços públicos com antecedência e pergunte não apenas se você pode obter 50 MW, mas quando e a que custo.
| Fator | Por que é importante | Bandeira vermelha |
|---|---|---|
| Rede Elétrica | 300+ MW necessários para hiperescala; interconexão leva de 18 a 48 meses | Alimentador de utilidade única, sem plano de redundância |
| Rotas de fibra | Múltiplas operadoras necessárias para redundância e preços competitivos | Apenas um caminho de fibra disponível |
| Clima | O resfriamento representa 30-40% do uso de energia; clima frio=resfriamento gratuito | Clima quente e úmido com má qualidade do ar |
| Desastres Naturais | Inundações, terremotos e furacões causam interrupções prolongadas | Local na zona de inundação da FEMA ou falha geológica sísmica |
| Regulamentos | Zoneamento, restrições hídricas e conformidade com ESG variam de acordo com a região | Área-com estresse hídrico impedindo o resfriamento evaporativo |
| Incentivos | Reduções fiscais e isenções de equipamentos podem economizar milhões | Incentivos com cláusulas de recuperação vinculadas a métricas de trabalho |
O clima merece atenção especial porque afeta diretamente os seus custos operacionais. Uma instalação de 10 MW em Phoenix pode gastar até 20% mais anualmente em refrigeração do que uma instalação comparável em Portland. Os climas mais frios permitem o resfriamento-com ar livre, onde o ar externo é usado diretamente quando a temperatura e a umidade são adequadas, reduzindo drasticamente a energia de resfriamento mecânico. É por isso que as instalações de hiperescala no norte da Europa reportam regularmente valores de PUE de 1,03 a 1,12.
O risco de desastres naturais deve ser avaliado utilizando mapas de perigos da FEMA, dados sísmicos do USGS e padrões meteorológicos históricos. A disponibilidade de água é cada vez mais examinada: Utah e Arizona pausaram ou negaram licenças para novos data centers devido a preocupações com a água, e algumas jurisdições agora exigem sistemas de circuito-fechado ou de refrigeração-seca.
Infraestrutura de energia: o coração da instalação
Os sistemas elétricos respondem por 40 a 50% do custo total de construção de data centers. Eles são o subsistema mais caro e também o mais crítico: sem energia, nada mais importa. Compreender a arquitetura de energia é compreender a relação entre custo e confiabilidade.
Sistemas UPS: dupla-conversão vs. linha-interativa
A fonte de alimentação ininterrupta é a ponte entre a rede elétrica e seus geradores. Quando a energia da rede falha, o UPS fornece energia instantânea das baterias enquanto os geradores são ligados, um processo que normalmente leva de 10 a 30 segundos. A escolha da topologia do UPS afeta tanto o custo quanto a confiabilidade.
UPS de-conversão dupla (on-line)converte continuamente CA de entrada em CC e de volta em CA limpa, proporcionando isolamento elétrico completo de distúrbios da rede elétrica. O tempo de transferência é zero durante falhas de energia. Esta topologia detém 44,65% de participação nas receitas do mercado de UPS para data centers e é o padrão para instalações Tier III e IV. Sistemas modernos como o 2025 Galaxy VXL da Schneider Electric alcançam 99% de eficiência no modo eConversion, reduzindo perdas abaixo de 1%. O custo é aproximadamente 35% maior do que as alternativas-interativas de linha.
Linha-UPS interativaé a alternativa-de custo-benefício para implantações de pequeno-a-médio, oferecendo custo aproximadamente 40% menor. É adequado para instalações Tier I e II, mas não é recomendado para data centers Tier III ou IV, onde a distorção harmônica e o tempo de transferência são inaceitáveis.
Topologias de redundância: N+1 vs. 2N vs. 2N+1
A topologia de redundância determina o que acontece quando um componente falha. As três arquiteturas principais representam pontos diferentes na curva de-confiabilidade de custos:
| Topologia | Descrição | Tolera | Melhor para |
|---|---|---|---|
| N+1 | Uma unidade de backup para cada sistema crítico | Falha de componente único | Empresarial, tempo de atividade moderado |
| 2N | Dois caminhos de energia totalmente independentes, cada um dimensionado para 100% de carga | Perda de um caminho inteiro | Nível III/IV, treinamento de IA |
| 2N+1 | Dois caminhos independentes mais uma unidade redundante compartilhada | Falha no caminho mais falha na unidade | Nível IV, infraestrutura crítica |
Para clusters de treinamento de IA, a escolha entre N+1 e 2N tem implicações econômicas que vão além da pura confiabilidade. Os trabalhos de treinamento de IA perdem o progresso devido à perda de energia não planejada e exigem a reinicialização a partir do último ponto de verificação. Quando a duração do trabalho é longa e os intervalos dos pontos de verificação são amplos, o custo de uma única reinicialização geralmente excede a diferença de capital entre N+1 e 2N. Os operadores devem mapear a duração do trabalho e a frequência do ponto de verificação em relação ao tempo de reparo do caminho de energia antes de escolher.
Densidade de potência: a revolução da IA
Os data centers empresariais tradicionais operam com 3 a 5 kW por rack. As instalações modernas em hiperescala visam 10 a 30 kW. Instalações-otimizadas para IA? 50 a 140 kW por rack. Os racks GB200 NVL72 da NVIDIA são classificados em 130 a 140 kW. Os racks OCP ORv3{19}}HPR V4 da Meta aumentam a capacidade de carga do gabinete para 800 kW. A Vertiv projeta que a densidade de potência em nível de rack de IA aumentará de 50 kW para 1 megawatt entre 2024 e 2029.

Esta não é uma mudança incremental. É uma mudança de paradigma. Uma instalação construída há dez anos para racks de 5 kW possui distribuição de energia, refrigeração e gerenciamento de cabos projetados para essa densidade. Você não pode colocar um rack de GPU de 140 kW naquela instalação e esperar que funcione. O barramento, a PDU, o painel de disjuntores, a unidade de refrigeração e o piso elevado foram todos dimensionados para uma época diferente. É por isso que instalações otimizadas-com IA custam US$ 20 milhões ou mais por megawatt, em comparação com US$ 10 a US$ 12 milhões para construção em hiperescala padrão.
Estratégia de resfriamento: mover calor, não apenas produzir frio
O resfriamento é responsável por 30 a 40% do consumo total de energia de um data center. É o maior fator controlável na PUE depois da própria carga de TI. E é a área onde a revolução da IA teve o impacto mais dramático, porque a refrigeração a ar tradicional simplesmente não consegue acompanhar os racks de 140 kW.
Resfriamento de ar tradicional: CRAC e CRAH
As unidades de ar condicionado da sala de computadores (CRAC) e de tratamento de ar da sala de computadores (CRAH) resfriam o ar antes de recircula-lo pelo data hall. Esta abordagem funciona bem para densidades de até 10 a 30 kW por rack, mas à medida que a densidade aumenta, o consumo de energia dos ventiladores aumenta rapidamente e a eficiência diminui. Combinado com a contenção de corredor quente/corredor frio, que separa o ar quente de exaustão do ar frio fornecido, o resfriamento de ar tradicional pode atingir valores de PUE de 1,4 a 1,8.
A contenção do corredor quente/frio é um requisito de projeto para qualquer meta séria de PUE abaixo de 1,2. Sem contenção, mistura de ar quente e frio, o sistema de refrigeração funciona mais e a eficiência cai drasticamente. Painéis cegos em posições de rack vazias, penetrações de piso vedadas e caminhos de ar de retorno controlados não são recursos opcionais; eles são requisitos fundamentais de design.
Resfriamento líquido: a mudança inevitável
Para densidades acima de 30 a 50 kW por rack, o resfriamento do ar atinge uma parede física. A quantidade de ar necessária para remover tanto calor torna-se impraticável: a energia do ventilador domina, os níveis de ruído tornam-se perigosos e o grande volume de movimento do ar cria preocupações estruturais. É aqui que o resfriamento líquido entra em cena.
Resfriamento líquido diretocircula o refrigerante através de placas frias montadas diretamente em CPUs e GPUs, removendo o calor na fonte antes que ele se espalhe pelo servidor. Essa abordagem atinge valores de PUE de 1,03 a 1,15 e suporta densidades de rack de 50 a 80 kW. A desvantagem-é uma rede de tubos e bombas que aumenta o risco de vazamentos e levanta preocupações de compatibilidade de hardware.
Resfriamento-de imersão monofásicosubmerge servidores inteiros em um fluido dielétrico não{0}}condutivo, eliminando totalmente a necessidade de ventiladores internos do servidor. Isso atinge valores de PUE de 1,02 a 1,10 e pode suportar densidades superiores a 100 kW por rack. As alterações no fluxo de trabalho operacional são significativas: os técnicos não podem abrir casualmente um servidor para trocar um DIMM. Mas o desempenho térmico é incomparável.
Resfriamento por imersão-duas fasesusa um sistema selado onde o fluido dielétrico ferve e condensa para transferência de calor, alcançando os valores mais baixos de PUE (1,02 a 1,08) e a maior capacidade de densidade. Quase todo o calor do servidor é capturado pelo fluido, criando condições térmicas uniformes que prolongam a vida útil dos componentes. A compensação-é um investimento inicial mais alto e um gerenciamento complexo de fluidos.
Para instalações brownfield que expandem para cargas de trabalho de IA, o resfriamento híbrido combina resfriamento a ar e líquido no mesmo edifício. Isso permite a preservação de racks refrigerados-a ar existentes e, ao mesmo tempo, implanta refrigeração líquida onde a densidade exige, possibilitando a modernização em fases sem uma reconstrução completa. A refrigeração líquida também proporciona benefícios mensuráveis de sustentabilidade: a investigação da Microsoft mostra que reduz as emissões de gases com efeito de estufa em 15 a 21%, a procura de energia em 20% e a utilização de água em 52% em comparação com a refrigeração a ar.
PUE: a métrica de eficiência universal
A Eficácia do Uso de Energia é a relação entre a potência total da instalação e a potência do equipamento de TI. Um PUE de 1,0 significa que cada watt vai para a computação. Um PUE de 1,5 significa meio watt de sobrecarga para cada watt de computação. É a métrica mais citada na eficiência do data center, e entender sua posição em relação aos benchmarks do setor é essencial.
A PUE média do setor é de aproximadamente 1,56, de acordo com a Pesquisa Global de Data Centers de 2024 do Uptime Institute. Relatórios do Google 1.09. Relatórios da Microsoft 1.12. Relatórios AWS 1.15. As instalações-de melhor desempenho, usando resfriamento por imersão em climas frios, alcançam 1,03 a 1,08. Os data centers corporativos típicos funcionam entre 1,4 e 1,6, e instalações acima de 1,6 são consideradas abaixo da média.
Como os hiperescaladores alcançam valores de PUE tão baixos? Não se trata de uma única tecnologia, mas de uma combinação: resfriamento com economizador lateral de ar que usa o ar externo quando a temperatura é adequada, sistemas economizadores laterais de água que rejeitam o calor sem compressão mecânica, temperaturas mais altas de fornecimento de água gelada (aumentando de 6 a 8 graus para 14 a 18 graus Celsius), resfriamento direto por líquido e por imersão que remove o calor na fonte e otimização do fluxo de ar-alimentado por IA que pode reduzir a energia de resfriamento em até 30%.
A pressão regulamentar está a aumentar os riscos. A Lei de Eficiência Energética da Alemanha exige que os novos data centers a partir de julho de 2026 atinjam uma PUE de 1,2 ou melhor, e que as instalações existentes atinjam 1,5 até 2027 e 1,3 até 2030. A Diretiva de Eficiência Energética da UE exige relatórios anuais de sustentabilidade para data centers acima de 500 kW de potência de TI instalada, abrangendo 24 indicadores de sustentabilidade, incluindo PUE, eficácia no uso da água, fator de energia renovável e fator de reutilização de energia.
Arquitetura de Rede: O Sistema Nervoso
Um data center sem rede é apenas um armazém caro cheio de metal quente. O projeto da rede determina a rapidez com que os dados se movem entre os servidores, como a instalação se conecta ao mundo externo e com que elegância o sistema lida com as falhas. Para cargas de trabalho de IA, o design da rede é indiscutivelmente mais importante do que a capacidade computacional bruta, porque os clusters de GPU gastam uma parte significativa do seu tempo esperando pelos dados.

Spine-Folha: o padrão moderno
A arquitetura Spine-Leaf substituiu os designs tradicionais de três-níveis (acesso-de agregação-núcleo) em data centers modernos. É uma topologia plana de duas-camadas em que cada switch leaf (topo-do-rack) se conecta a cada switch de coluna, criando uma malha sem-bloqueio e baixa-latência. Cada servidor pode alcançar todos os outros servidores em exatamente dois saltos, o que é fundamental para cargas de trabalho de IA em que a latência de comunicação de GPU-para{12}}GPU afeta diretamente o tempo de treinamento.
Para clusters de IA que usam GPUs NVIDIA H100 ou B200 com Ethernet 400G ou NDR400 InfiniBand, a estrutura da coluna-folha é quase sempre baseada em fibra-para links de expansão-para{7}}folha e folha-para{9}}rack{10}}escalonável. A estrutura de GPU-para-GPU em um rack usa NVLink/NVSwitch para comunicação de latência ultra-baixa-, enquanto os links MPO de fibra lidam com a rede-de expansão entre switches e racks.
Seleção de fibra: OM4, OM5 ou OS2?
A seleção do tipo de fibra é um dos tópicos mais debatidos em redes de data centers, e a resposta certa depende inteiramente do seu alcance e estratégia óptica:
| Tipo de fibra | Melhor para | Alcance 400G | Custo |
|---|---|---|---|
| OM3 | Empresa legada, baixa densidade | 100G-SR4 a 300m | Mais baixo |
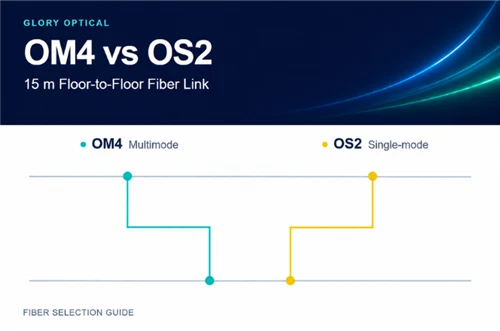
| OM4 | Folha-de IA padrão, links curtos | 400G-SR8 a 100m | Moderado |
| OM5 | Vários-comprimentos de onda com SWDM4 | 400G-Somente SR8 a 150 m | Prêmio |
| SO2 | Backbone, inter-construção, DCI | 400G-DR4 a 500m | Maior custo óptico |
Para clusters de IA atuais com links abaixo de 100 metros, o OM4 continua sendo a escolha-com melhor custo-benefício. Em 400G, os transceptores multimodo são normalmente 30 a 50% mais baratos por porta do que as alternativas-de modo único. No entanto, para se preparar-para o futuro, muitas operadoras usam fibra escura OS2 juntamente com OM4, permitindo upgrades para 800G ou 1,6T sem re-cabeamento. O cabo de fibra em si é barato; é na óptica que os custos se acumulam.
Gerenciamento de cabos: o diabo está nos detalhes
Uma área onde os data centers falham consistentemente é a limpeza dos conectores. Cada extremidade-do conector MPO deve ser inspecionada com um microscópio portátil com ampliação de 200x ou 400x antes do acoplamento. Uma única partícula de poeira em um conector MPO pode causar erros de bits, retransmissões e tempos limite de operação coletiva da GPU que são extremamente difíceis de diagnosticar. Limpe os conectores usando o método dry clicker ou wet{6}}dry de acordo com IEC 61300-3-35. Teste a polaridade dos cabos tronco MPO com um testador de continuidade calibrado, pois a incompatibilidade de polaridade Tipo A/B causa falhas de link que parecem intermitentes e aleatórias.
A fibra multimodo tem um raio de curvatura mínimo de 10 vezes o diâmetro do cabo sob carga e 7,5 vezes sem carga. A violação do raio de curvatura causa perdas por macrocurvatura que degradam silenciosamente a qualidade do sinal. Para fibra-monomodo, não são permitidos arranhões ou defeitos na zona central dentro de um raio de 0 a 25 micrômetros. Esses detalhes parecem triviais até que uma execução de treinamento de IA de vários{8}}milhões-de dólares falha devido a um conector sujo.
Realidade de custos: o que realmente é necessário
Falemos de dinheiro, porque todo o resto deste artigo é teórico até você entender a estrutura de custos. Um data center de hiperescala padrão em 2025 custará de US$ 10 a US$ 12 milhões por megawatt. Uma instalação de 50 MW custa entre US$ 800 milhões e US$ 1 bilhão. Uma instalação-otimizada para IA ultrapassa US$ 1 bilhão por 50 MW e pode chegar a US$ 20 milhões ou mais por MW. Construções de IA-em escala universitária de 1 gigawatt ou mais podem atingir US$ 45 a US$ 55 bilhões por GW.
A repartição dos custos conta a história: os sistemas eléctricos representam 40 a 50% do custo de construção, os sistemas mecânicos e de refrigeração 15 a 20%, e o invólucro estrutural e o núcleo o restante. O hardware de TI acrescenta US$ 20 a US$ 40 milhões por megawatt além da construção, e o ajuste da GPU de IA- acrescenta um prêmio de US$ 25 milhões ou mais por megawatt. Uma instalação otimizada-de IA de 100 MW requer US$ 2 a US$ 4 bilhões em servidores, redes e aceleradores, elevando o investimento inicial total para US$ 3 a US$ 5,2 bilhões.
Do lado operacional, a energia é a maior despesa, normalmente 40 a 60% de todas as despesas operacionais. Um data center de IA de 1 GW em plena capacidade consome cerca de 8,76 TWh anualmente, traduzindo-se em aproximadamente US$ 350 milhões por ano a US$ 40 por MWh. A US$ 0,15 por kWh, um local em escala de gigawatt-enfrenta custos anuais de energia de aproximadamente US$ 1,3 bilhão. A atualização de hardware em um ciclo de vida de 3 a 5 anos para GPUs-de ponta acrescenta centenas de milhões em gastos anuais efetivos.
O caminho a seguir: o que está mudando e por que é importante
A indústria de data centers está passando pela transformação mais significativa de sua história. Três forças estão convergindo: a explosão da computação da IA, a mudança para a implantação modular e de ponta e o imperativo da sustentabilidade. Compreender essas tendências não é opcional para ninguém envolvido no planejamento de instalações.
Os data centers modulares estão remodelando os cronogramas de implantação. O mercado modular global foi avaliado em US$ 34,84 bilhões em 2025, com previsão de atingir US$ 143,08 bilhões até 2034, com 17,2% de CAGR. As instalações modulares são implantadas em 12 a 16 semanas, em comparação com anos para a construção tradicional, custam aproximadamente 30% menos por kW e reduzem-o desperdício no local em até 90%. Para a computação edge e a integração 5G, a modularidade é a única abordagem viável para o volume de implementações necessárias.
A arquitetura de energia HVDC está ganhando força para instalações de IA. A Delta Electronics estima a eficiência da cadeia HVDC em aproximadamente 92% em comparação com a eficiência tradicional do UPS de 88%, eliminando diversas etapas de conversão CA-para-CC e CC-para-CA. As grandes operadoras poderiam economizar cerca de US$ 3,6 milhões anualmente em custos de eletricidade através da adoção de HVDC. Os racks OCP ORv3-HPR V4 da Meta apresentados no 2025 EMEA Summit usam uma solução HVDC de 800 V, aumentando a capacidade de carga do gabinete para 800 kW.
A inferência de IA está prestes a ultrapassar a formação como principal impulsionador da procura de computação, prevendo-se que esta mudança ocorra em 2027. Esta mudança tem implicações para a concepção dos centros de dados: clusters de formação em grandes instalações centrais, inferência distribuída em locais periféricos mais próximos dos utilizadores. O setor está caminhando em direção a uma arquitetura central-região-de borda multi{4}}camadas.
Conclusão: Construindo para os Próximos Vinte Anos
Configurar um data center é um exercício de compensações. Cada decisão envolve equilibrar custo e confiabilidade, eficiência e complexidade, velocidade e meticulosidade. O sistema de níveis informa o quão confiável você precisa ser. PUE informa o quão eficiente você é. O TIA-942 informa se o seu projeto é abrangente. Mas nenhuma dessas estruturas tomará as decisões por você.
Os fundamentos são estes: escolha o seu local com base na disponibilidade de energia e no clima, não apenas no custo do terreno. Projete sua energia e resfriamento para a densidade que você realmente operará, não para a densidade que você espera operar algum dia. Crie uma rede spin{2}}leaf com fibra OM4 para links curtos e OS2 para backbone. Implemente segurança física em zonas concêntricas desde o primeiro dia. Implante o DCIM antes de precisar dele, não após o primeiro incidente. Faça um orçamento para a energia como sua maior despesa operacional e planeje a sustentabilidade não como um fardo de conformidade, mas como uma vantagem competitiva.
E lembre-se disto: o data center que você constrói hoje irá operar por 15 a 25 anos. As cargas de trabalho que serão executadas em 2035 ainda não existem. As densidades de potência que precisará suportar estão além do que a maioria dos projetos atuais pode suportar. Construa para flexibilidade, construa para densidade e construa para a possibilidade de que tudo o que você acha que sabe sobre engenharia de data center seja reescrito quando sua instalação atingir a meia-idade.